豆包搜索排名是什么:字节系 AI 搜索的引用逻辑与提升思路
豆包搜索排名不是百度那种带序号、可竞价的位次,而是GEO:当用户在字节的对话式AI豆包里问到你这一摊事,你的内容能否被它联网检索到、被当成可信来源、摘进生成的答案。它和抖音SEO同吃字节内容池(头条图文、抖音、百科、官网)却是一个生态两个入口,打法不能照搬。内容上不去的真实原因通常是:模型够不着你、够得着但全是形容词不可摘、各处口径互相打架不敢信、踩了绝对化或像批量生成、意图没对上——没有一条是外链买少了。多久更新没有稳定天数,它是模型知识加实时检索的混合体,别信“提交后X天上榜”。能实做的是提高事实密度、做可摘取结构、多源口径一致、覆盖真实提问。被提到但说错比没提到更伤。豆包内部如何排序引用是不公开且常变的黑箱,以上为可操作判断,不承诺任何名次或被引用结果。
本文目录
"豆包搜索排名"这五个字,被讲得太玄了。我先把话说平:豆包是字节跳动做的一个对话式 AI 助手,你问它问题,它要么靠自己训练的模型回答,要么联网去检索一批内容、再综合成一段话给你,有时末尾会带上引用来源。所谓"让豆包搜索排名靠前",真实含义不是去抢一个像百度那样能截图、能买到的第几名,而是——当有人在豆包里问到你这一摊事时,你的内容能不能被它检索到、被它当成可信来源、被它摘进那段生成的答案里。这就是 GEO(生成式引擎优化)落在豆包这个具体产品上的样子。这篇我不吹数据、不编案例,就按豆包这个产品到底怎么运转,讲清楚它和抖音 SEO、和百度搜索排名的区别,以及你能做实的事。先交底:豆包内部怎么排序、引用谁,是不公开也一直在变的,我给的是可操作的判断,不承诺任何"排到第几"或被引用的结果。
先分清:豆包搜索、抖音 SEO、百度排名,是三件事
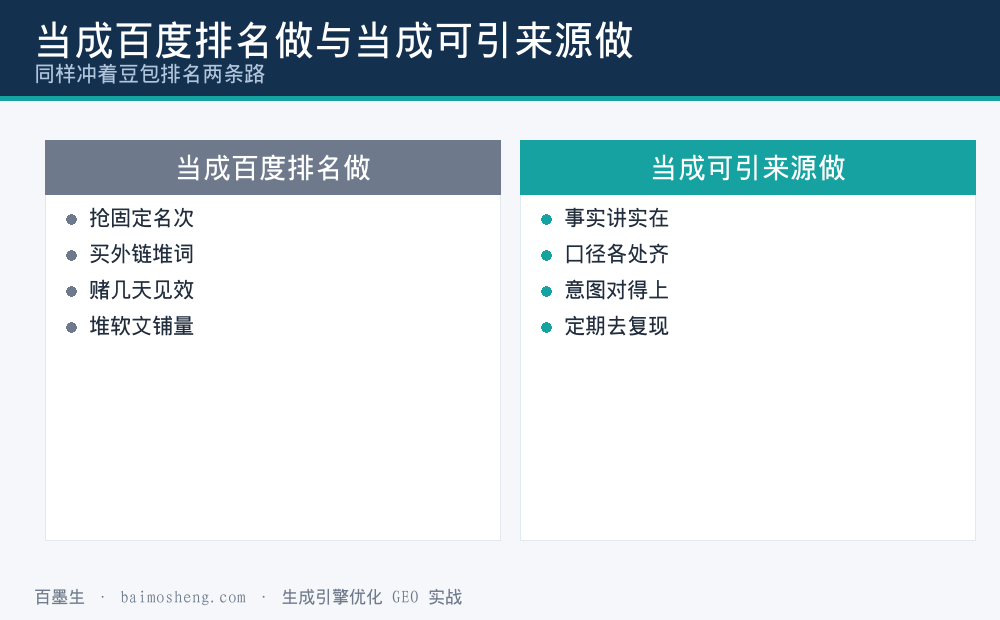
这三样太容易被混成一个词,但它们根本不是一个东西,做错了力气全白费。百度排名,是传统搜索里那条带序号、可竞价、可做的蓝链排序,你能看到一个位次。抖音 SEO,是抖音站内搜索的排序——用户在一个 App 里搜视频,讲究的是完播、互动、账号权重这些站内信号,本质还是个"找内容的搜索框"。豆包搜索不一样:它是个会说话、会联网、会综合的 AI,用户丢进来的是一整句问题,它吐出来的是一段答案加几个引用,没有一个固定的"第三名"给你抢。共同点是——它们背后都吃字节那套内容池(豆包联网检索时,今日头条的图文、抖音的内容、以及百科、官网这些中文来源都在它的够得着的范围里)。所以你会看到一个有意思的现象:同一条内容,可能既在抖音搜索里被排、又在豆包答案里被引,因为它们是一个生态、两个入口。但打法不能照搬:把抖音 SEO 那套埋词、堆完播的思路直接搬来"做豆包排名",多半使错了劲。
豆包的一条回答是怎么拼出来的
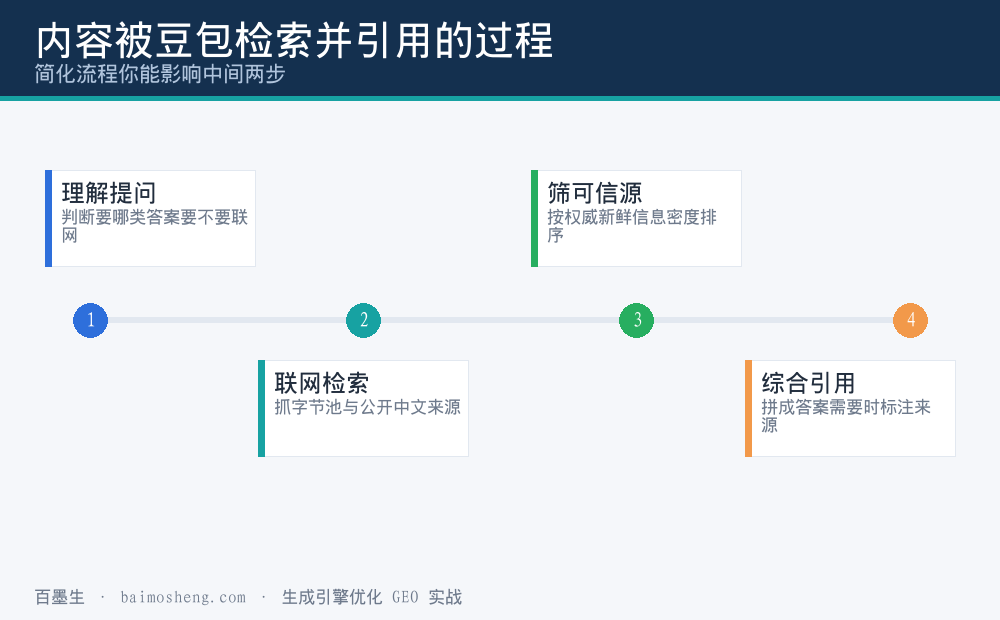
不用懂模型,但大致过程值得知道,因为它直接说明你能在哪使劲。第一步,理解你的问题到底在问什么、想要哪类答案;第二步,判断要不要联网——像"某产品多少钱""某地哪家好"这种有时效、有具体对象的,它会去检索,纯常识类的它可能直接靠模型内部知识答;第三步,把检索到的一批来源做可信度筛选,权威、新鲜、信息密度高的往前排;第四步,才是把筛过的内容综合成一段话,需要时标上引用。你能施加影响的,是第二、三步:让自己出现在它够得着的中文来源里,并且以"事实清楚、口径一致、看着可信"的样子出现。第四步是豆包的活,你改不了,谁号称能改豆包的排序,基本是在唬你。
为什么你的内容在豆包里"上不去"
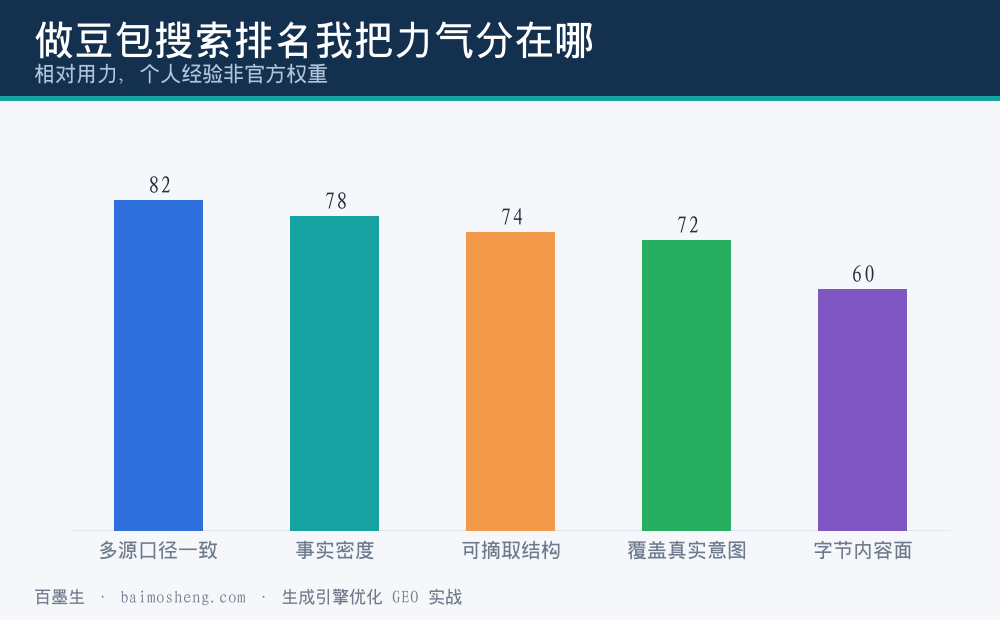
这是问得最多的一句。我把常见原因按概率排一排,你对着自己查。一是最根本的:它在字节生态和公开中文互联网里,够得着你——你的信息只锁在自家官网一个角落,别处搜不到,模型抓不到你就是抓不到。二是够得着但读不懂:通篇形容词、没有能独立成立的事实句,模型没法从你这段里摘出一块干净的话放进答案。三是读得懂但不敢信:你在官网、百科、平台主页上说的是三套口径(有的成立于某年有的另一年,有的价格高有的低),模型一交叉比对就给你降级。四是踩了它警惕的东西:绝对化承诺、堆词、看起来像广告或像 AI 批量生成的残次内容。五是意图没对上:用户问的是"我这具体情况怎么办",你写的是"我们公司多厉害",答非所问自然轮不到你。你会发现,没一条是"外链买少了""关键词密度不够"——那套 SEO 直觉在豆包这儿基本不成立。
豆包搜索排名多久更新一次?别指望这个数
很多人想要一个准数:"我改了内容,豆包几天会更新?"老实说,没人能给你一个稳定的天数,因为它不是一个定时刷新的榜单,而是模型训练知识 + 实时联网检索的混合体。联网检索那部分,理论上你被重新索引可能比较快;但模型自身"记得"你是谁、你做什么,取决于它什么时候再抓到、再更新对中文语料的理解,这个节奏不透明、也和你没关系地一直在变。所以正确的心态不是"算几天见效",而是两件事:一是把该做对的信息持续做对、别过时;二是定期自己拿问题去豆包问一遍,看现在它怎么说——用复现代替猜测。指望"提交后 X 天上榜"的,要么是不懂,要么是给你画饼。
能实做的,还是那四件(落到豆包上)
去掉玄学,动作很朴素。第一,提高事实密度:把你的产品、服务、价格、适配场景、边界条件写成一条条能独立成立的事实句,让模型摘得动——形容词它不认。第二,做可摘取结构:一段只讲一个意思,该用小标题就用,让机器能顺畅切出一块完整的话塞进答案。第三,多源口径一致:在官网、百科、字节系内容平台、行业媒体上,把"你是谁、做什么"说成同一套,别自己跟自己打架,豆包靠多来源交叉一致来判断可信。第四,覆盖真实提问:把用户会整句丢给豆包的问题收集起来(带场景、带"多少钱、哪家好、有什么坑"的那种),对着这些意图写,而不是自说自话。这四件是通用的 GEO 地基,只是喂给豆包这个具体入口时,你要额外记得它背后是字节那套内容生态。
别把豆包排名做成又一次买外链、堆关键词
做惯传统 SEO 的人一听"要让豆包能读到",条件反射就是回去老套路:买一堆低质平台发软文、堆关键词、批量铺外链。在大模型这儿,这条路基本是反的。豆包筛的是可信、信息密度高、能交叉验证的来源;一大片互相拷贝、空话堆砌、没有事实增量的页面,不但不会被引用,还会把你这个实体的画像往"不靠谱"那边拉。更要命的是这些低质页几乎一定会跟你官方口径打架,等于自己埋一堆矛盾信息。真正常青的做法是少而精:把有限力气投在能被模型当回事的那几个中文来源上,把它们写实在、对齐一致,而不是铺一摊没人信的垃圾。这跟追一个"豆包第几名"的位次相比,听着不性感,但它是唯一有复利的方向。
一个具体的判断:豆包提到你、但说错了,比没提到更糟
这一条我要单独拎出来,因为它最容易被忽略。你可能只盯着"有没有被豆包提到",但真正该盯的是"提到时说得对不对"。豆包如果把你说成了"做 A 业务的、在 B 城市、价位 C",而这三样里有任一样是错的(多半是从某个过时或矛盾的页面上摘串了),用户是带着这个错误预期来找你的——电话一打、咨询一问,对不上,信任当场崩。这种"被提到但被说歪"的伤害,远大于安安静静没被提到。所以做豆包 GEO,有一大块活不是写新内容,而是去清过时信息、去对齐各处口径、把那些互相矛盾的旧页改掉或下线。听起来不像"优化",但它对你在豆包里的真实表现,影响比多发几篇软文大得多。
怎么验证你在豆包里到底做得怎么样
方法很实在,不需要任何内部渠道。列一张"你的用户会整句问 AI 的真实问题"清单,去豆包里用带场景的完整问法挨个问(别问"XX 好吗"这种空的,要问"我在某情况、要解决某事,选哪家合适、大概多少钱、有什么坑"这种它真会联网检索的)。然后看两件事:有没有提到你或你这个方向;提到时说得对不对。把每次结果记下来,滚动补——没提到,就回去查是不是字节生态和中文来源覆盖不够、意图没写到;说错了,就去清过时、对齐口径。豆包(和它背后模型)一有版本更新,这批验证就重跑一遍,因为答案的引用会跟着变。这件事不性感,但它是你唯一能抓住的、可复现的反馈闭环。
对大多数想做豆包的企业,我的取舍建议
别把"豆包搜索排名"当成一个能单独攻坚的排名位来赌。它是你整套 GEO 地基在豆包这个入口上的投影:地基(事实真、结构可摘、口径一致、意图覆盖)打好了,豆包、通义、文心、乃至以后新出的模型,都能同时受益;专门为豆包一个入口去搞"黑科技",投入产出比通常很差,还容易踩到买外链、堆词这些在模型这儿反作用的老路。合理的顺序是:先确认自己在公开中文互联网上被说得清、对得齐(这是所有 AI 问答的共同前提),再顺带留意豆包特别依赖的字节系内容面。把豆包当"其中一个出口",而不是"要打榜的靶子",很多焦虑和弯路就都省了。真正让人夜里睡不着的,从来不是豆包没把你排到第几,而是用户问对了、你却没在它能看见的地方把话说清楚。
豆包答案里的引用长什么样,你能争取什么
用豆包问带时效或具体的问题,它有时会在答案下面挂几条来源,点进去是你没写、甚至不认同的页面——这恰恰说明那篇被它当成了素材。你要争取的,不是"控制它引用哪条"(控制不了),而是让你自己那篇成为它更愿意抓、更敢信的那一条:标题就是用户会问的那句话、开头先把最硬的事实摆出来、通篇是它能在字节生态和公开中文互联网里交叉验证上的东西。反过来,那些看着像批量生成、口径和别处对不上、动不动"最强第一"的页,即便被检索到也常在筛选那关就被刷掉。所以别研究"怎么写能骗过引用",就研究"怎么写能让它少犹豫",这是同一件事的两面。
个人或小团队做豆包 GEO,最划算的三件事
没团队、没预算,也有的做,而且顺序很关键。第一件,先把"你是谁、做什么、在哪、大概什么价"这套基本事实,在官网加一到两个你真正活跃的中文平台上写成完全一致的一版——这是所有 AI 问答的共同地基,花不了几天,回报却覆盖豆包、通义、文心全部。第二件,挑你最能答好的三五个"用户会整句问的问题",一个一个写透,别贪多、别铺关键词,写那种你自己客服天天在答的具体问题。第三件,定一个笨但有效的复现闭环,比如每月拿那几个问题去豆包问一遍,记下提没提到、说没说错,照着补。三件事没有一件需要买工具、找代运营,全靠把自家事说实、说清、说一致——这本来就是该做的经营,只是加了"让机器读得懂"的意识。
这篇的边界
把能负责和不能负责说清。我能负责的是:上面这套关于豆包是什么、它和抖音 SEO 与百度排名的区别、一条回答怎么拼出来、上不去的几类真实原因、多久更新没有准数、四件实事、别买外链堆词、被说错比没提到更糟、用真实问题清单复现验证——这些是你能自己动手、也能自己复现的判断,做了不会白做。我不能负责的是豆包内部到底怎么检索、怎么排序、引用谁、何时更新——那是不公开、一直在变的,我不掌握,也不会向你保证任何"豆包排名第几"或被引用的结果。我不编客户数、不编"多少百分比从业者有误解"这种看着专业实则拍脑袋的数字。涉及豆包的具体能力和商用规则,以字节官方文档为准。把这篇当一张帮你分清"哪些值得投、哪些是话术"的地图,别当一键出效果的公式。
常见问题
豆包搜索排名是什么?和百度排名一样吗?
不一样。百度排名是传统搜索里带序号、可竞价、能看到的蓝链位次;豆包搜索是字节的对话式 AI,把问题联网检索后综合成一段答案、可能附引用,没有可买卖的固定名次。“做豆包排名”的真实含义是让你的内容被豆包检索到、当成可信来源、摘进答案,属于 GEO,而不是抢一个位次。
豆包搜索排名和抖音 SEO 是一回事吗?
不是,但相关。抖音 SEO 是抖音站内搜索对视频的排序,吃的是完播、互动、账号权重这些站内信号;豆包搜索是 AI 问答对一整句问题的生成式引用。共同点是两者都吃字节那套内容池(头条图文、抖音内容、百科、官网等),所以同一条内容可能既在抖音被搜到、又在豆包被引用。但打法不能照搬,把埋词堆完播那套直接搬来做豆包,多半使错劲。
为什么我的内容在豆包里搜不到、上不去?
按概率排查:模型够不着你(信息只锁在官网一角、别处搜不到);够得着但读不懂(全是形容词、没有可摘的事实句);读得懂但不敢信(各处口径互相打架、信息过时);踩了它警惕的东西(绝对化承诺、堆词、像批量生成的残次内容);意图没对上(你写“我们多厉害”,用户问“我这情况怎么办”)。没有一条是“外链买少了”。
豆包搜索排名多久更新一次?改完几天见效?
没有一个稳定的天数。豆包是模型内部知识加实时联网检索的混合体,不是定时刷新的榜单:联网部分可能较快被重新索引,但模型“记得你”更新得更慢且不透明。正确心态不是算几天见效,而是把信息持续做对、别过时,并定期自己拿问题去问、看它现在怎么说,用复现代替猜测。
做豆包排名要不要买外链、批量发软文?
不建议,这条在模型这儿基本是反的。豆包筛可信、信息密度高、能交叉验证的来源;一堆互相拷贝、空话堆砌的低质页不但不被引用,还把你的实体画像往“不靠谱”拉,且几乎一定和官方口径打架。真正有用的是少而精:把能被当回事的那几个中文来源写实在、对齐一致。被提到但说错,比没提到更伤,所以清理过时和矛盾信息往往比多发软文更值钱。
常见问题
豆包搜索排名是什么?和百度排名一样吗?
不一样。百度排名是传统搜索里带序号、可竞价、能看到的蓝链位次;豆包搜索是字节的对话式AI,把问题联网检索后综合成一段答案、可能附引用,没有可买卖的固定名次。做豆包排名的真实含义是让你的内容被豆包检索到、当成可信来源、摘进答案,属于GEO,而不是抢一个位次。
豆包搜索排名和抖音SEO是一回事吗?
不是但相关。抖音SEO是抖音站内搜索对视频的排序,吃完播、互动、账号权重等站内信号;豆包搜索是AI问答对一整句问题的生成式引用。共同点是两者都吃字节那套内容池(头条图文、抖音内容、百科、官网等),同一条内容可能既在抖音被搜到又在豆包被引用。但打法不能照搬,把埋词堆完播那套直接搬来做豆包多半使错劲。
为什么我的内容在豆包里搜不到、上不去?
按概率排查:模型够不着你(信息只锁在官网一角);够得着但读不懂(全是形容词没有可摘事实句);读得懂但不敢信(各处口径互相打架、信息过时);踩了它警惕的东西(绝对化承诺、堆词、像批量生成);意图没对上(你写我们多厉害,用户问我这情况怎么办)。没有一条是外链买少了。
豆包搜索排名多久更新一次?改完几天见效?
没有稳定天数。豆包是模型内部知识加实时联网检索的混合体,不是定时刷新的榜单:联网部分可能较快被重新索引,但模型记得你更新得更慢且不透明。正确心态不是算几天见效,而是把信息持续做对别过时,并定期自己拿问题去问、看它现在怎么说,用复现代替猜测。
做豆包排名要不要买外链、批量发软文?
不建议,这条在模型这儿基本是反的。豆包筛可信、信息密度高、能交叉验证的来源;一堆互相拷贝、空话堆砌的低质页不但不被引用,还把实体画像往不靠谱拉,且几乎一定和官方口径打架。真正有用的是少而精,把能被当回事的中文来源写实在、对齐一致。被提到但说错比没提到更伤,清理过时和矛盾信息往往比多发软文更值钱。
资料与参考来源
Array
文章讨论
登录后参与讨论。