GEO 优化的底层逻辑是什么:AI 决定引用谁时,背后到底发生了什么
GEO 起作用的底层逻辑:生成式 AI 回答问题是“先检索、再筛选、后拼答案”(检索增强)——它把检索当中间步骤,拿到一批候选后自己读、按相关/可信/一致/新鲜/可摘做筛选,组织成一段结论并标来源,用户不再自己翻十条链接。于是你能不能被引用,取决于五件事:①在不在它够得着的检索源里(写在私域/要登录处它捞不到);②信息能不能被整段摘取(模型抽的是能独立成立的事实句,形容词套话它摘不动也越来越会识别);③多个公开来源对你的基本事实是否一致(它会交叉验证,口径打架它要么不敢用、要么错误引用你,负面引用比沉默更伤);④对不对得上人们真实的提问意图(覆盖没人这么问的词就没机会被召回);⑤内容新不新鲜。被引用本质是不稳定的概率而非锁定名次(生成有随机性、模型持续更新、不同模型检索源不同),所以正确心态是长期把上述素质做扎实、提高每次被选中概率,而非指望做到某状态就永久稳。GEO 与 SEO 共享地基(可抓取、真实价值、结构清楚)但往上分叉(争取被引用 vs 争排序位),别把堆词买链盯排名直接套过来。最该死磕三件事:做有信息增量可摘的内容、把主要来源事实对齐、围绕真实提问意图覆盖。以上是基于公开可观察行为构建的机制模型、非任何大模型官方算法,不保证一定被引用。
本文目录
前面我写过怎么挑做 GEO 的服务商、也写过自己动手具体怎么做,这两篇都偏"动作"。这篇想往回退一步,讲清楚一件事的底层:GEO 到底为什么会起作用,你在豆包、DeepSeek 里问一个问题、它决定引用谁的时候,背后大概发生了什么。我把这层讲透,不是为了显得高深,是因为你一旦理解了机制,很多"该做什么、不该做什么"就不用死记教程了,自己能推出来。先说清楚边界:各家模型怎么排序、怎么决定引用,是不公开、还一直在改的黑箱,我下面讲的是能公开观察、也讲得通的机制模型,不是一条保证你被引用的公式。
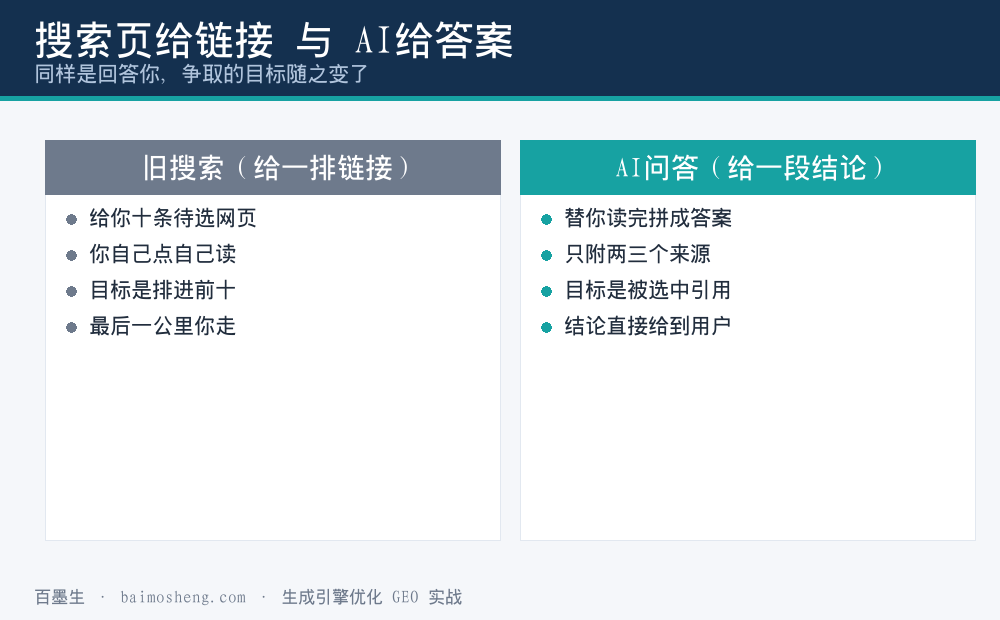
最根本的变化:从"给你一排链接"到"替你拼一段答案"
过去二十年的搜索,逻辑是"检索":你输入词,系统理解成一个查询,去它的索引里找出一排最相关的网页,摆成十条蓝链,让你自己点、自己读、自己判断。信息的"最后一公里"是你走的。生成式 AI 把这件事改了:它把检索只是当成中间一步,拿到一堆候选之后,自己读、自己总结、自己组织成一段看起来已经回答完整的文字,往往只附两三个来源。差别看着小,实质很大——原来用户面对的是"一堆待选的源",现在面对的是"一个已经做好的结论"。GEO 之所以是个新问题,就是因为在这个链条里,你的内容要争取的不再只是"排进前十让人点",而是"被模型选中、当作它拼答案时的材料"。
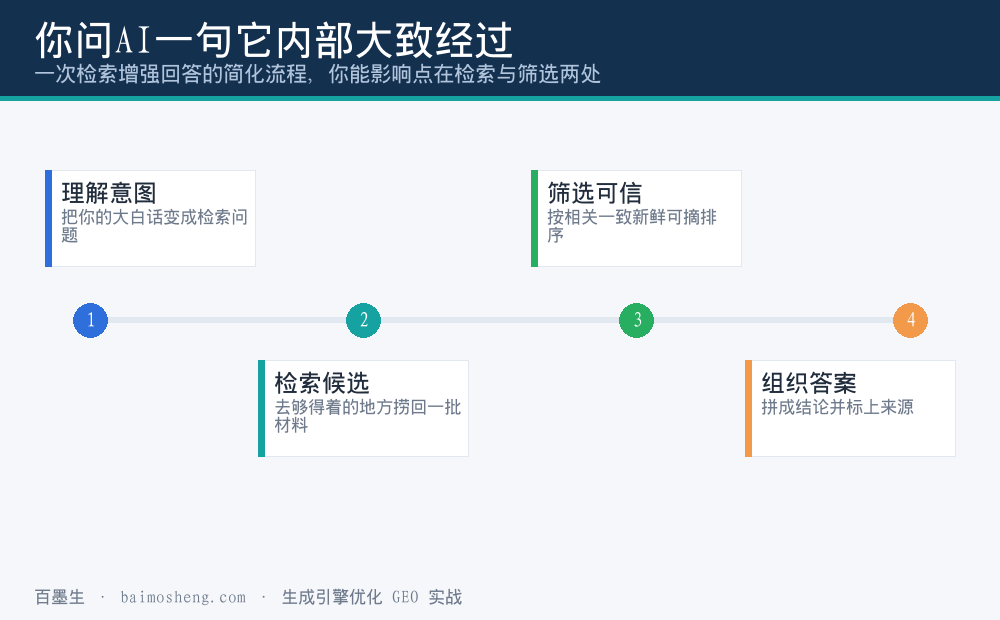
拆开看:AI 回答一次提问,大致经过了哪几步
主流做法(业内叫检索增强,说人话就是"先查再答")大致是这样几步,理解它就理解了 GEO。第一步,模型先理解你那句大白话到底想问什么,把它变成一个检索意图。第二步,它去自己够得着的地方捞候选:可能是它训练时见过的内容,也可能是实时检索回来的一批网页、摘要、结构化数据。第三步,它给这些候选做筛选和排序——哪些跟问题真相关、哪些来源它觉得可信、信息新不新、能不能直接摘出来用。第四步,它把筛出来的碎片组织成一段连贯回答,并标上来源。你看,你要影响的不是某一个"排名开关",而是这条链上好几处:你得先在它够得着的地方(第二步)出现,还要在筛选那一步(第三步)被判定为相关、可信、能摘。任何一环掉链子,都不会被引用。
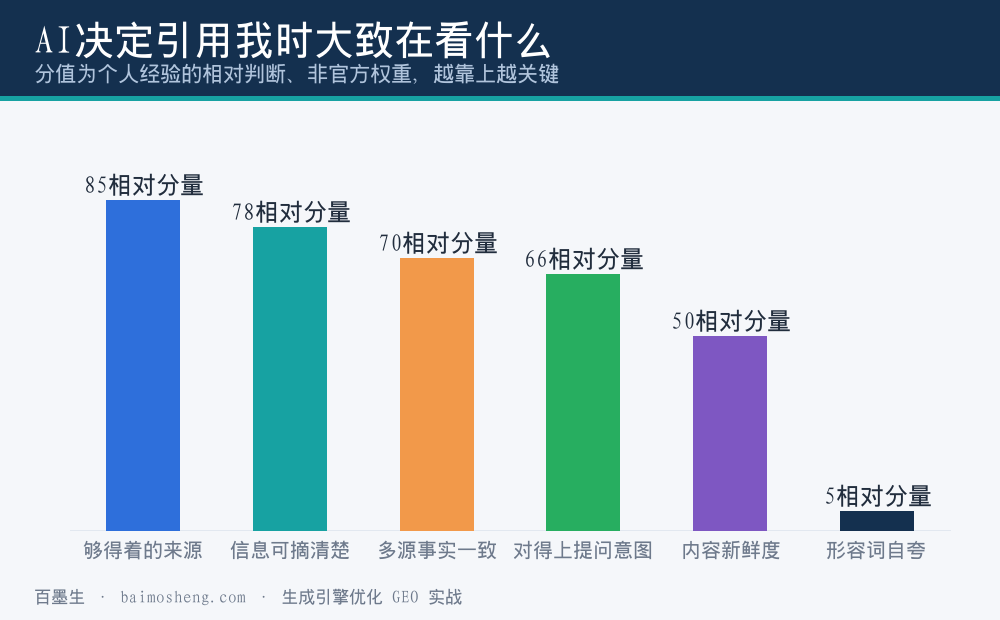
于是"被不被引用"其实取决于这么几件事
把上面那步再往下推,你的内容能不能被选中引用,取决于几件你能感知的事。第一,在不在它够得着的地方——你写在私域、写在要登录才看得到的地方,它根本捞不到你。第二,信息能不能被摘——模型抽取的是"讲清一件事的句子",一大段情绪化、没实指的话它摘不动。第三,多个来源对你是不是说得一致——它常常交叉比对,你对自己各个公开渠道口径打架,它就不敢确信该用哪个版本。第四,对不对得上真实的提问意图——你覆盖的是没人这么问的词,而不是人们会整句问出来的问题,就匹配不上检索意图。第五,新不新鲜——明显过时、甚至已经作废的信息,即使被抓到也可能被降权。这五件事没有一件是"神秘技巧",全是你能理解、也大多能自己动手改善的。
为什么"事实与一致性"在 GEO 里的分量,比在 SEO 里更重
在旧搜索里,一致性做没做好主要影响用户体验,排序还有很多别的信号可以补偿。但在 AI 拼答案这件事上,一致性几乎是门槛。原因很直接:模型要把你的信息当成"能对外说出口的答案",它得先在心里确认"这个说法靠得住"。而它确认靠不靠得住的一个朴素办法,就是看别的来源是不是也这么说你。如果你叫 A、在另一个平台简介写成 A+、业务范围几个地方各说一套,模型拼出来的你是一团自相矛盾的碎片,它要么干脆不用你,要么用错你——用错比不用更糟,因为那是带着你名字的误导。所以把"我是谁、我做什么、有哪些拿得出手的事实"在主要公开来源上对齐,是 GEO 底层逻辑直接推出来的一件高价值的事,它不是玄学的"权重优化",是让模型敢信你。
为什么形容词几乎没用,信息增量才有用
这也得从机制上讲。模型抽取的是能被独立成立、能拿去回答的"信息句"。"我们品质卓越、值得信赖"这种话,没有任何具体所指,模型摘出来放进答案既没意义也增加出错风险,它天然不爱用;而且现在的模型对"没有信息增量的营销套话"识别得越来越好,你写得越多越像噪音。反过来,"这项服务的计价方式是按面积、常见区间是某值、适合某类场景、不适合某类场景",这种带事实、带条件的话,模型摘得动、用得放心。理解到这一层,你就不会再犯"把官网文案写得更华丽"这种方向性错误——GEO 要的不是文采,是清楚、具体、可摘取的事实密度。
为什么"这次被引用、下次就没了"——它本质是不稳定的
很多人做 GEO 有个困惑:明明昨天问提到我,今天问又没了,是不是我哪里做错了。多数时候不是你错了,是这件事本来就不稳定。模型生成带有一定随机性,同一个问题两次措辞可能给你排不同的来源;模型版本一更新,引用偏好就可能变;不同模型、不同检索源捞到的候选池本来就不一样。所以"被引用"更像一种概率,不是一个一旦达成就锁定的名次。这决定了 GEO 的正确心态:不是"做到某个状态就稳了",而是"持续把上面那几件事做好,提高你在一次次提问中被选中的概率"。谁要是跟你说"搞定一次永久霸榜 AI",要么不懂机制,要么在骗你。
GEO 和 SEO 的真实关系:共享地基,往上分叉
理解了机制,你就能准确回答"GEO 是不是取代 SEO"这个老问题——不是取代,是有一部分地基共用、往上各走各的。共用的地基是:内容得能被正常抓取、得有真实价值、结构得清楚——这些对搜索引擎和对 AI 检索都需要,做好一套对两边都有益。往上就分叉了:SEO 那支还要研究爬虫、外链、页面体验、在结果页的排序位置;GEO 这支更在意"在检索增强那几步里能不能被判定为可信、可摘、对得上意图"。所以务实的判断是:SEO 该做的别扔,那是地基;但别拿纯 SEO 的思路(堆词、买链、盯排名)去套 GEO,那会在分叉处走偏。
为什么"投喂、隐藏文字、堆词"看着像捷径,其实是坑
正因为懂了机制是"相关+可信+一致+可摘",你就能看穿那些走捷径的把戏为什么靠不住。往页面塞一堆人看不见、只想骗检索的字,短期可能蹭到一点匹配,但它不增加你真正的信息增量,还可能被识别为操纵;批量造同质内容,稀释的是你自己的内容质量信号;最伤的是它常常破坏一致性——你在各处乱发口径不一的软文,模型拼出来的你更混乱,引用信心反而下降。GEO 的底层逻辑其实一直在奖励同一类人:踏踏实实把信息做真、把内容做清楚、把各处口径对齐的人。想抄近道,往往是在往这个机制的反方向使劲。
“被提到但说错了”,为什么比没被提到还糟糕
这里得单独拆一个很多人忽略的点:引用分两种,一种是把你说过且说对了,另一种是提到了你但信息是错的、过时的、甚至是别人的事张冠李戴到你头上。后者叫负面引用,它对品牌的伤害比沉默大多了——因为前者只是没帮你,后者是在用你的名义误导用户,而用户往往全盘相信 AI 那段结论。为什么会出现负面引用?通常是你够得着的来源太少、AI 只能从不完整甚至混乱的信息里猜你,或者你各处口径不一致、它把矛盾的两半拼错了。这反过来印证了前面那两条逻辑:内容要多、要清楚,事实要一致,不然你不但不会被正确引用,还可能被错误引用。所以监测的时候别只盯着“有没有提到”,要盯着“提到时说得对不对”,后者才是真正要守住的。
GEO 里的“权威”从哪来:不是自封,是被凑出来的
模型判断一个来源可不可信,不会听你自称“行业领先”,它靠的是间接证据拼出来的印象。哪些证据?大致有这么几类:你的信息能不能在多个独立、它觉得靠谱的地方交叉对上;引用你的地方本身是不是有点分量(行业媒体、专业社区、维基类条目这些它相对信);你的内容是不是长期稳定、不乱改口径;有没有人把它当参考。这就像一个人的名声——不是自己喊出来的,是别人怎么提你、各处说法合不合、经不经得起查,一起凑出来的。理解这点你就知道,想把 GEO 里的“权威”做起来,靠自夸没用,得实打实地把自己的真信息铺到它信任的地方、并对齐口径,让它交叉验证时得出“这个来源靠得住”的结论。
打个比方,帮你把底层逻辑记牢
你可以把 AI 组织一次回答,想象成一场"临时招聘"。你的内容是一个来面试的候选人。能不能被"录用"(被引用),取决于几件事:你投没投到它看得见的渠道(在不在它够得着的检索源里),你简历上有没有真东西(信息增量还是空话),你前后说法一不一致、背景查得到查不到(多源事实一致),你的能力对不对得上这个岗位(匹不匹配提问意图),你的经验是不是还新鲜(时效)。它每次从一堆候选人里挑几个,标准大致稳定但会有波动,还时不时换一套偏好(模型更新)。所以你要做的不是"贿赂面试官",而是长期把这五项真实素质做扎实——这几乎是整篇底层逻辑的通俗版本。
从底层逻辑推出来,你最该死磕的就三件事
把机制收束成行动,我认为核心就三条,别的都是它的衍生。第一,做有信息增量、写得可摘取的内容——这决定了你"有没有资格被用",是 1,后面都是 0。第二,把主要公开来源上的事实对齐、把身份拼自洽——这决定模型"敢不敢用你"。第三,围绕人们真实的提问意图去覆盖,而不是围绕关键词——这决定你在"哪些具体问题"上有机会被召回。技术面的可抓取、速度、结构化,是给这三条铺路、别拖后腿的;监测和长期维护,是验证这三条做没做到位的。抓住这三件,你就抓住了 GEO 的七寸,不必被各种花哨说法带着跑。
这篇的边界
老实交代:上面讲的这套底层逻辑,是我根据公开可观察的产品行为和从业经验,构建的一个"能自圆其说、也指导行动"的机制模型,不是任何一家大模型披露的官方算法。真实情况肯定更复杂,而且一定在不断变化——它们怎么检索、怎么给候选排序、引用阈值多少,全是黑箱。所以我不能保证你按这个理解去做就一定会被引用。我能负责的是:这套理解是自洽的、有解释力的,它推出来的每一个建议(做真内容、保持事实一致、覆盖真实意图、别走捷径、接受不稳定性、长期维护)都站得住、也都你亲自验证得了。你把它当一张地图用,别当一部操作手册背,结合自己业务的实际去试、去复现,方向和分寸你自己把握,我不替任何模型替任何结果打包票。
普通人最容易带偏的一个直觉
最后提一个认知坑。很多人一听“AI 会引用我”,直觉就想去“讨好算法”:找什么关键词能命中、加什么代码能被抓取、发多少篇能堆上去。但从底层逻辑看,这些都是在细枝末节上使劲。真正决定你被不被用的,是一个更像常识的判断:你是不是一个“说真话、说得清楚、到处对得上、正好能回答这个问题”的来源。把这个做对了,不需要你去猜算法,模型自然愿意用你;这个没做对,堆再多技巧都是沙上建塔。GEO 听起来新,底层奖励的其实是很旧、很稳的东西——真实、清楚、一致。早点把这个直觉扳过来,能帮你避开一大半白费的力气。
常见问题
GEO 的底层逻辑一句话是什么?
AI 回答问题是“先检索到一批候选、再筛出可信可摘的、拼成答案”。你要争取的不是排第几,而是进入它够得着的候选、并在筛选时被判定为相关、可信、一致、能摘取、对得上问题。把这几件事做扎实,被引用的概率自然上去。
为什么 AI 有时引用我、有时又不引用?
这很正常,不是你做错了。生成有随机性、模型版本会更新、不同模型检索的源也不同,所以“被引用”是一种概率而不是锁定的名次。正确心态是持续做好内容和一致性、提高每次被选中的概率,而不是指望做到某个状态就永久稳了。
做 GEO 为什么反复强调“事实一致”?
因为 AI 拼答案时会交叉比对多个来源,确认你这个说法靠不靠得住。你在各平台名字、范围、信息各说一套,它拼出来的你是自相矛盾的碎片,要么不敢用你、要么用错你(带着你名字的误导,比不用更糟)。对齐口径是让模型“敢引用你”的门槛。
GEO 是不是就是把 SEO 推翻重来?
不是,是共享地基、往上分叉。能被抓取、有真实价值、结构清楚这套地基,两边都要;但 SEO 那支盯结果页排序,GEO 这支盯检索增强里能不能被判定为可信可摘、对得上意图。别把纯 SEO 的堆词买链盯排名直接套到 GEO 上,会在分叉处走偏。
为什么隐藏文字、堆词、批量软文做 GEO 会翻车?
因为机制奖励的是真信息增量、可摘取、多源一致。塞看不见的字不增加真实增量还可能被识别为操纵,批量同质文稀释质量信号,各处发口径不一的软文反而破坏一致性、让模型更不敢信你。捷径往往是在往机制的反方向使劲。
常见问题
GEO 的底层逻辑一句话是什么?
AI 回答问题是“先检索一批候选、再筛出可信可摘的、拼成答案”。你要争取的不是排第几,而是进入它够得着的候选、并在筛选时被判定为相关、可信、一致、能摘取、对得上问题。把这几件事做扎实,被引用的概率自然上去。
为什么 AI 有时引用我、有时又不引用?
很正常,不是你做错。生成有随机性、模型版本会更新、不同模型检索的源也不同,所以被引用是一种概率而非锁定名次。正确心态是持续做好内容和一致性、提高每次被选中概率,而不是指望做到某个状态就永久稳。
做 GEO 为什么反复强调事实一致?
因为 AI 拼答案会交叉比对多个来源确认你靠不靠得住。你在各平台名字、范围、信息各说一套,它拼出来的是自相矛盾的碎片,要么不敢用你、要么错误引用你(带你的名字误导,比不用更糟)。对齐口径是让它敢引用你的门槛。
GEO 是不是就是把 SEO 推翻重来?
不是,是共享地基、往上分叉。能被抓取、有真实价值、结构清楚这套地基两边都要;但 SEO 盯结果页排序,GEO 盯检索增强里能不能被判定为可信可摘、对得上意图。别把纯 SEO 的堆词买链盯排名直接套到 GEO 上。
为什么隐藏文字、堆词、批量软文做 GEO 会翻车?
因为机制奖励真信息增量、可摘取、多源一致。塞看不见的字不增加真实增量还可能被识别为操纵,批量同质文稀释质量信号,各处发口径不一的软文反而破坏一致性、让模型更不敢信你。捷径往往是在往机制反方向使劲。
资料与参考来源
参考资料:GEO/生成式引擎优化对应生成式 AI 的检索增强问答(先检索候选、再筛选、后组织成带来源的答案)这一公开可观察的产品形态;文中“理解意图→检索→筛选→组织答案”的流程,以及“是否被引用取决于够得着的来源、可摘取性、多源事实一致、意图匹配、新鲜度”等判断,为百墨生基于从业观察构建的机制解释模型,非任何大模型官方披露的算法或权重(各家检索与引用机制不公开且持续变化);不保证按此理解即被引用,请以自己在各模型里的可复现实测为准。
文章讨论
登录后参与讨论。