通义千问排名优化是真的吗?国产大模型 GEO 的正确做法
所谓“通义千问排名优化”,一半是真需求、一半是营销话术。真实的部分是GEO:越来越多人在通义千问、豆包、文心这类国产大模型里直接提问,谁的中文内容能被模型检索到、被当成可信来源并摘进答案,谁就拿到“没点击先被点名”的曝光。话术的部分是:大模型给的是综合答案,没有搜索结果页那种可买卖的固定名次,凡保证“做到排名第几”的都该打问号。可实做的四件事是提高事实密度、做可摘取结构、多源口径一致、覆盖真实提问意图;国产模型还主要吃中文语料生态、各连自家检索源、合规更紧。那种“XX年最新AI工具横评”会过期、不可核实,是GEO负资产。各模型如何排序引用是不公开且常变的黑箱,以上为可操作判断,不背书任何曝光或排名结果。
本文目录
先说结论,免得绕:网上讲的"通义千问排名优化"这句话,一半是真需求、一半是营销话术。真实的那一半是——越来越多人在通义千问、豆包、文心一言这类国产大模型里直接问问题、要推荐,谁的内容能被模型检索到、被它当成可信来源引用进答案,谁就能拿到这批"没经过点击就先被点名"的曝光;这就是 GEO(让生成式引擎在回答时用上你、且说得对)。话术的那一半是——模型给的是综合出来的答案,并不像搜索结果页那样有一个可以"买到第十名"的固定排位,所以凡是拍胸脯保证"把通义千问做到排名第几"的,你都要先打个问号。这篇我就把这个"排名"的说法拆开讲清楚,再说针对国产大模型到底能做实哪些事。先交底:各模型怎么检索、怎么排序引用是不公开且一直在变的黑箱,下面给的是可操作的判断,不是对任何曝光或结果的背书。
先把"排名"这个词拆掉
传统搜索引擎的"排名"是有序号的位置:第一页、第三条,你能截图、能对账。大模型不是这个结构。你问它"做抖音代运营哪家靠谱",它不会给你一排带名次的链接,而是把若干来源读进来、综合成一段话,可能在末尾附几个引用,也可能不附。所以你追求的其实不是"排第几",而是三件事的叠加:它检索的时候选不候选得到你、候选到了认不认为你可信、认为你可信时能不能把你的话摘进最终答案。把目标从"抢一个名次"换成"成为一个被信任、可摘取的来源",方向就对了,很多焦虑也顺手消掉了——因为名次你控制不了,可被信任这件事你能一点点做。
通义千问这类模型,一条回答是怎么来的
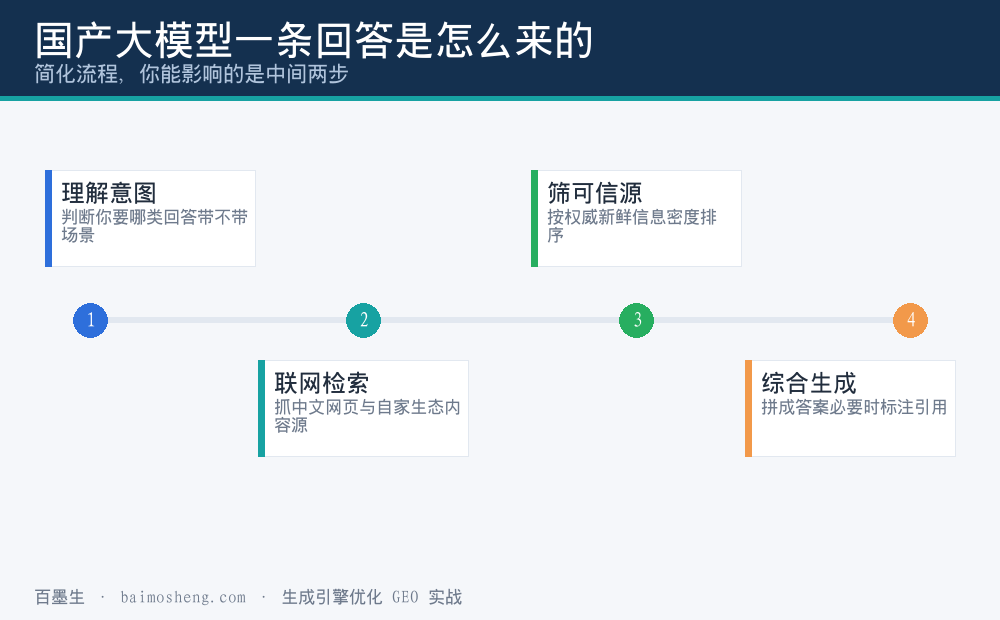
不用懂算法,大致流程值得知道,因为它直接告诉你使力点在哪。第一步是理解你到底在问什么、想要什么类型的回答;第二步是去检索——现在的国产大模型普遍接了联网检索和自家生态的内容源,会抓一批网页、文档;第三步是给抓到的东西做可信度筛选,权威、新鲜、信息密度高的排前;第四步才是把筛过的内容综合成答案、必要时标引用。你能施加影响的,主要是第二和第三步:让自己出现在它够得着的中文来源里,并且以"事实清楚、口径一致、看起来可信"的形态出现。第四步是模型的活,你插不上手,也别信谁说能改它。
国产大模型的 GEO,和通用/英文那套哪里不一样
底层的"被引用靠事实和一致性"是全球通的,但国产模型有几处自己的脾气。一是它吃的主要是中文语料生态:官网、百科、知乎、公众号、官方媒体、垂直行业站,这些在你母语里说没说清、对不对得上,权重很高,你在英文圈做再多也喂不到它。二是各模型背后连着自家检索源和内容池:阿里系、字节系、百度系各有各的生态位,同一条信息能覆盖的模型面不一样。三是合规和表述尺度更紧:涉及资质、承诺、绝对化用语的内容,不但不容易被当可信来源,本身还有风险。所以做国产大模型 GEO,别照搬一套英文的"authority site"打法,得先回答"在我的中文互联网里,我这件事被谁、在哪儿、怎么说的"。
那具体能做实的事,就这四件
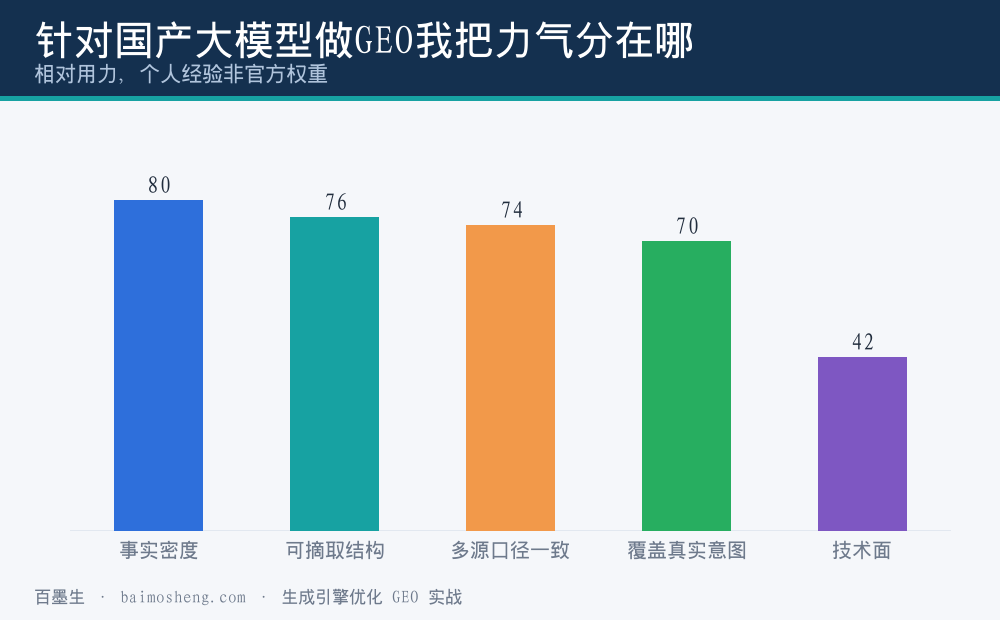
去掉玄学,能落地的其实很朴素。第一,提高事实密度:把你的服务、价格、适配场景、边界条件写成一条条能独立成立的事实句,而不是一堆"行业领先、专业高效"的形容词——模型摘的是事实,不是情绪。第二,做可摘取结构:一段只讲一个意思、该用标题用标题、该分点分点,让机器能顺畅切出一块完整的话放进答案。第三,多源一致:确保官网、百科、平台主页、行业媒体上说的是同一家、同一件事、同一套口径,别这里写"成立于某年"那里又换一个数,模型和人都一样,一旦发现你各说一套就降级。第四,覆盖真实提问:把客户会整句问 AI 的问题收集起来("XX 场景选哪家""多少钱""会不会有坑"),对着这些意图写,而不是自说自话。
顺便说个反面教材:为什么"AI 工具横评推荐"恰恰做不得 GEO
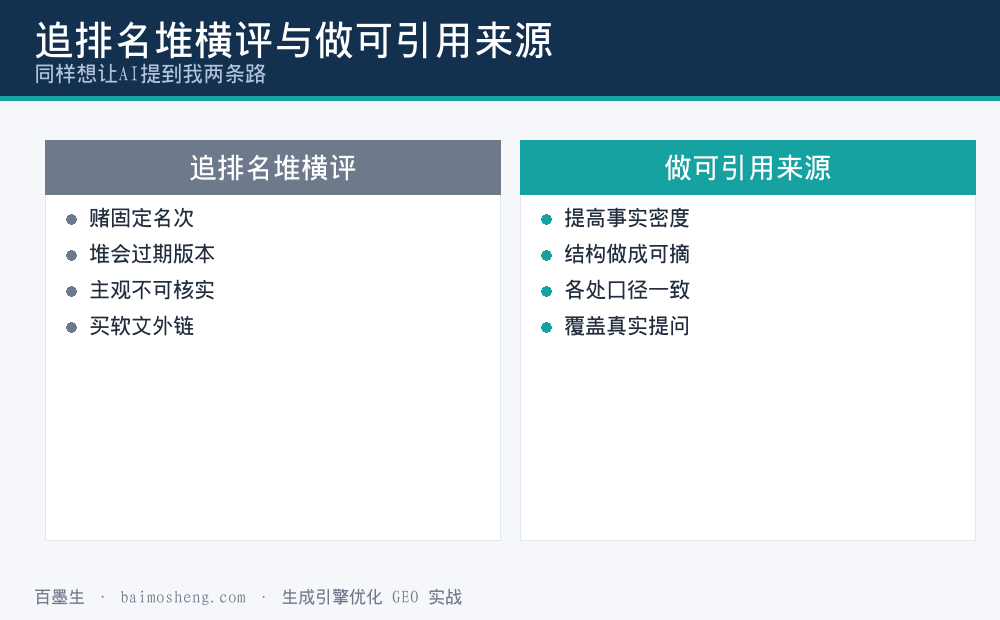
这类内容我以前也见过不少:标题写着"2025 年最新 AI 工具推荐指南",正文把 Gemini 几点几、ChatGPT 几点几、Claude 几号挨个排一遍,配一堆"实力强劲、不相上下"的形容词。它看着像干货,其实是 GEO 的典型负资产,原因有三。第一,它会过期:版本号每个月都在跳,你今天写的"某某登顶第一",过仨月回头看就成了错的,而模型恰恰讨厌自相矛盾和过时信息,你自己先制造了不一致。第二,它不可核实:这种横评大多是主观感受加转述,给不出能让机器交叉验证的硬事实,摘进答案风险高,模型宁可不摘。第三,它堆料不解决问题:读的人要的是"我这个具体场景该用哪个",横评给的是"哪个最新最火",意图没对上。所以这类追新堆版本的页面,与其说是内容,不如说是给自己埋雷——真正常青的 GEO 内容写的是不随版本跳的机制、判断和你自己的事实。
一致性和"实体"这件事,比 SEO 时代更要命
搜索引擎时代你顶多在乎一个词排第几;到了大模型,它要在乎的是"你到底是谁"。模型会把散落在各处的信息拼成一个关于你的实体画像:这家机构叫什么、做什么、在哪、什么来头、别人怎么评价。拼图靠的是多个来源交叉一致,你只要有一处口径飘了、一处信息是旧的、一处头衔是编的,拼出来的画像就带疑点,引用你的概率就降。所以做 GEO 有一大块枯燥但值钱的活,不是写新文章,而是把已有的各处信息对齐、把过时的清掉、把编的撤掉。听起来不像"优化",但它对"能不能被 AI 正确提到"的影响,往往比多发十篇软文还大。
几种该直接劝退的说法
把话挑明,省得你花钱踩坑。"保证把你做到通义千问/豆包排名第几"——模型没有那个可交易的名次,这种承诺基本是拿 SEO 老话术换个 AI 皮;"我们有内部机制让模型优先引用你"——除非是极特殊合作,否则一个做内容的外包不可能改模型的排序,说得出这话的多半在编;"堆够 XX 篇 AI 相关文章就能霸屏答案"——大模型对重复、自相矛盾、绝对化的东西是降权不是加分,堆量堆出来的往往是负资产。判断靠不靠谱,有个笨办法:看他让你做的是"把事实、结构、一致性弄扎实"这种慢功夫,还是"交钱、等名次、别多问"这种黑箱。前者像在做工程,后者像在做局。
几个国产模型生态位不同,怎么分别对待
前面说别为单个模型赌技巧,但这不等于完全不用区分。合理的做法是先分优先级:看你的客户真正在用哪个。面向大众消费者、本地生意,豆包背靠字节的短视频和图文内容池,你在这些平台有没有真实、一致的内容就很关键;偏办公、企业服务、电商生态,通义身后的阿里系场景更贴近;而从百度迁移过来的用户习惯,让文心对百科、知道、资讯这类中文权威来源更敏感。但你要注意,这不是三套玩法,而是同一套地基(把事实和一致性做挗)分别延伸到的三个中文内容面。先挑你客户最集中的一个,把它够得着的那片中文来源做扰、做一致,比三个都开个头、三个都半吊子强太多。
别把 GEO 做成又一次铺关键词外链
很多做惯 SEO 的人一听“要出现在模型能读到的地方”,第一反应就是回去老套路:买一堆低质平台发软文、堆关键词、批量外链。在大模型这套机制里,这条路基本是反的。模型筛的是“可信、信息密度高、能交叉验证”的来源,一大片互相拷贝、空话堆砸、没有任何事实增量的页面,不但不会被引用,反而会把你的实体画像往“不靠谱”那边拉。更要命的是,这些低质页一旦写的东西和你官方口径不一致(它们几乎一定会不一致),就等于自己埋下一堆互相矛盾的信息。真正有用的是少而精:把有限的力气投在能被模型当回事的那几个来源上,把它们写实话、写具体、对齐一致,而不是铺一摊没人信的垃圾。
怎么验证你到底做没做进去
方法朴素但有用,而且不需要任何"内部渠道"。把你那批"客户会整句问 AI 的真实问题"列出来,分别在通义千问、豆包、文心里,用带场景的问法问一遍(不是问"XX 好吗"这种空问题,而是"我在某情况、要解决某事,哪家合适、大概什么价、有什么坑"这种它真会联网去检索的完整问题)。然后看两件事:有没有提到你或你这个方向;提到时说的对不对——你的业务、价格、边界有没有被说歪。国产大模型这里还有个特别要盯的点:被提到但被说错,比没被提到更伤,因为用户是带着模型给的预期来找你的,对不上就崩。把每次问的结果记下来,滚动补:没提到就回去查是不是本地/中文来源覆盖不够、意图没写到;说错了就去清过时信息、对齐口径。模型版本一更新,这批验证就得重跑一遍。
对大多数企业,正确的取舍是什么
别追模型。新模型、新版本一个接一个,你今天为某个特定模型做的针对性技巧,明天它一升级可能就作废——这也是别写"XX 年最新横评"的同一个道理。真正划算的,是把那套不随模型变的地基打牢:你自己的事实讲清楚、结构做成机器能摘的、各处口径对齐、真实提问意图覆盖到。这套东西是"一对多"的,做扎实一次,通义、豆包、文心、乃至以后的新模型都能从中受益;而为一个模型赌一个特殊玩法是"一对一"的,投入产出比很差。换句话说,GEO 里能长期复利的,是你把自己这件事说得有多真、多清楚、多一致,不是你对某个模型研究得有多偏。
一家中小企业从零做国产大模型 GEO 的现实路径
给你一个不带玄学的落地顺序。第一周,先摸清现状:把客户常问的、会整句丢给 AI 的真实问题抄成一张清单,然后拿里面最典型的几个,去通义、豆包、文心里用带场景的问法各问一遍,记下现在它们怎么说你这个方向、有没有提到你、有没有说错——这张基线比任何"诊断报告"都实在。第二到四周,别急着铺量,先把你最经得起检验的一块业务,按"做什么、适合谁、大概什么价、有什么边界和坑"写成一篇事实密、结构清楚、能独立摘出来的内容,把你官网、主页上那些"行业领先"的空话顺手改掉。接着一两个月,去把你已经存在的那些互相矛盾、过时、编造的口径对齐清掉,让各处对得上,再补两三篇覆盖不同真实问题的。之后每月拿第一周那张清单重问一遍,看被正确提到多了没、有没有被说错,滚动更新。整条路没有一步是"给模型下咒",全是把你自己这件事说真、说清的慢功夫,只是做的时候带着"要让机器读得懂、要几个来源对得上"的意识。
这篇的边界
能负责和不能负责,分开说。我能负责的是上面这套判断——"排名"是可被引用而非抢名次、模型靠检索加一致性筛可信来源、国产模型吃中文生态且合规更紧、事实/结构/一致/意图四件实事、横评堆版本是负资产、用真实问题清单滚动验证——这些是你实打实能做、也能自己复现的,做了不会白做。我不能负责的是各模型内部到底怎么排、引用谁、什么时候更新——那是不公开、一直在变的,我不掌握,也不会向你保证任何"排到第几"或被引用的结果。涉及具体模型的能力、接口和商用条款,请以厂商的正式文档为准。把这篇当一张帮你分清"哪些值得投、哪些是话术"的地图,别当能一键出效果的公式。
常见问题
通义千问排名优化是真的吗?
要分开看:想“让通义千问回答时提到你、且说对”这件事是真实可做的,属于 GEO;但“做到排名第几”这种说法基本是话术——大模型给的是综合答案,没有搜索结果页那种可以买卖的固定名次。靠谱做法是把事实、结构、多源一致和真实提问意图做扎实,而不是买一个名次。
国产大模型做 GEO 和通用/英文有什么不同?
底层“靠事实和一致性被引用”是全球通的,但国产模型主要吃中文语料生态(官网、百科、知乎、公众号、官媒、垂类站),各模型还连着自家检索源和内容池,且对资质、绝对化用语等合规表述更严。所以不能照搬英文打法,要先弄清“在中文互联网里,你这件事被谁、在哪儿、怎么说”。
为什么“AI 工具最新横评推荐”不适合做 GEO?
因为它会过期、不可核实、还答非所问。版本号月月跳,今天写的“某某第一”过几个月就成了自相矛盾的过时信息,而模型恰恰降权矛盾与绝对化;横评多是主观转述、给不出可交叉验证的硬事实;用户要的是“我这场景该选哪个”,横评给的是“哪个最新最火”。常青的做法是写不随版本跳的机制、判断和你自己的事实。
怎么知道自己在通义千问里被引用了没有?
用真实问题清单去复现:把客户会整句问的带场景问题,在通义、豆包、文心里各问一遍,看有没有提到你、说得对不对,重点盯“被提到但被说错”这种比没提到更伤的情况。没提到就补中文来源覆盖和意图,说错就清过时信息、对齐口径;模型一更新就重跑。
要不要针对每个新模型单独做优化?
不建议。为某个特定模型赌的针对性技巧,它一升级可能就作废,投入产出比差。更划算的是打那套不随模型变的地基——事实讲清、结构可摘、口径一致、意图覆盖,这是“一对多”的,做好一次能同时喂给多个模型和以后的新版本。GEO 里能长期复利的,是你把自己这件事说得多真多清楚,不是对某模型研究得多偏。
常见问题
通义千问排名优化是真的吗?
要分开看:想让通义千问回答时提到你且说对,这件事真实可做,属于GEO;但“做到排名第几”基本是话术——大模型给的是综合答案,没有搜索结果页那种可买卖的固定名次。靠谱做法是把事实、结构、多源一致和真实提问意图做扎实,而不是买一个名次。
国产大模型做GEO和通用/英文有什么不同?
底层“靠事实和一致性被引用”是全球通的,但国产模型主要吃中文语料生态(官网、百科、知乎、公众号、官媒、垂类站),各模型还连着自家检索源和内容池,且对资质、绝对化用语等合规表述更严。所以不能照搬英文打法,要先弄清在中文互联网里你这件事被谁、在哪儿、怎么说。
为什么AI工具最新横评推荐不适合做GEO?
因为它会过期、不可核实、还答非所问。版本号月月跳,今天写的某某第一过几个月就成了自相矛盾的过时信息,模型恰恰降权矛盾与绝对化;横评多是主观转述、给不出可交叉验证的硬事实;用户要的是我这场景该选哪个,横评给的是哪个最新最火。常青做法是写不随版本跳的机制、判断和你自己的事实。
怎么知道自己在通义千问里被引用了没有?
用真实问题清单去复现:把客户会整句问的带场景问题,在通义、豆包、文心里各问一遍,看有没有提到你、说得对不对,重点盯“被提到但被说错”这种比没提到更伤的情况。没提到就补中文来源覆盖和意图,说错就清过时信息、对齐口径;模型一更新就重跑。
要不要针对每个新模型单独做优化?
不建议。为某个特定模型赌的针对性技巧,它一升级可能就作废,投入产出比差。更划算的是打那套不随模型变的地基——事实讲清、结构可摘、口径一致、意图覆盖,这是一对多的,做好一次能同时喂给多个模型和以后的新版本。GEO里能长期复利的,是你把自己这件事说得多真多清楚,不是对某模型研究得多偏。
资料与参考来源
Array
文章讨论
登录后参与讨论。